
5 دقیقه
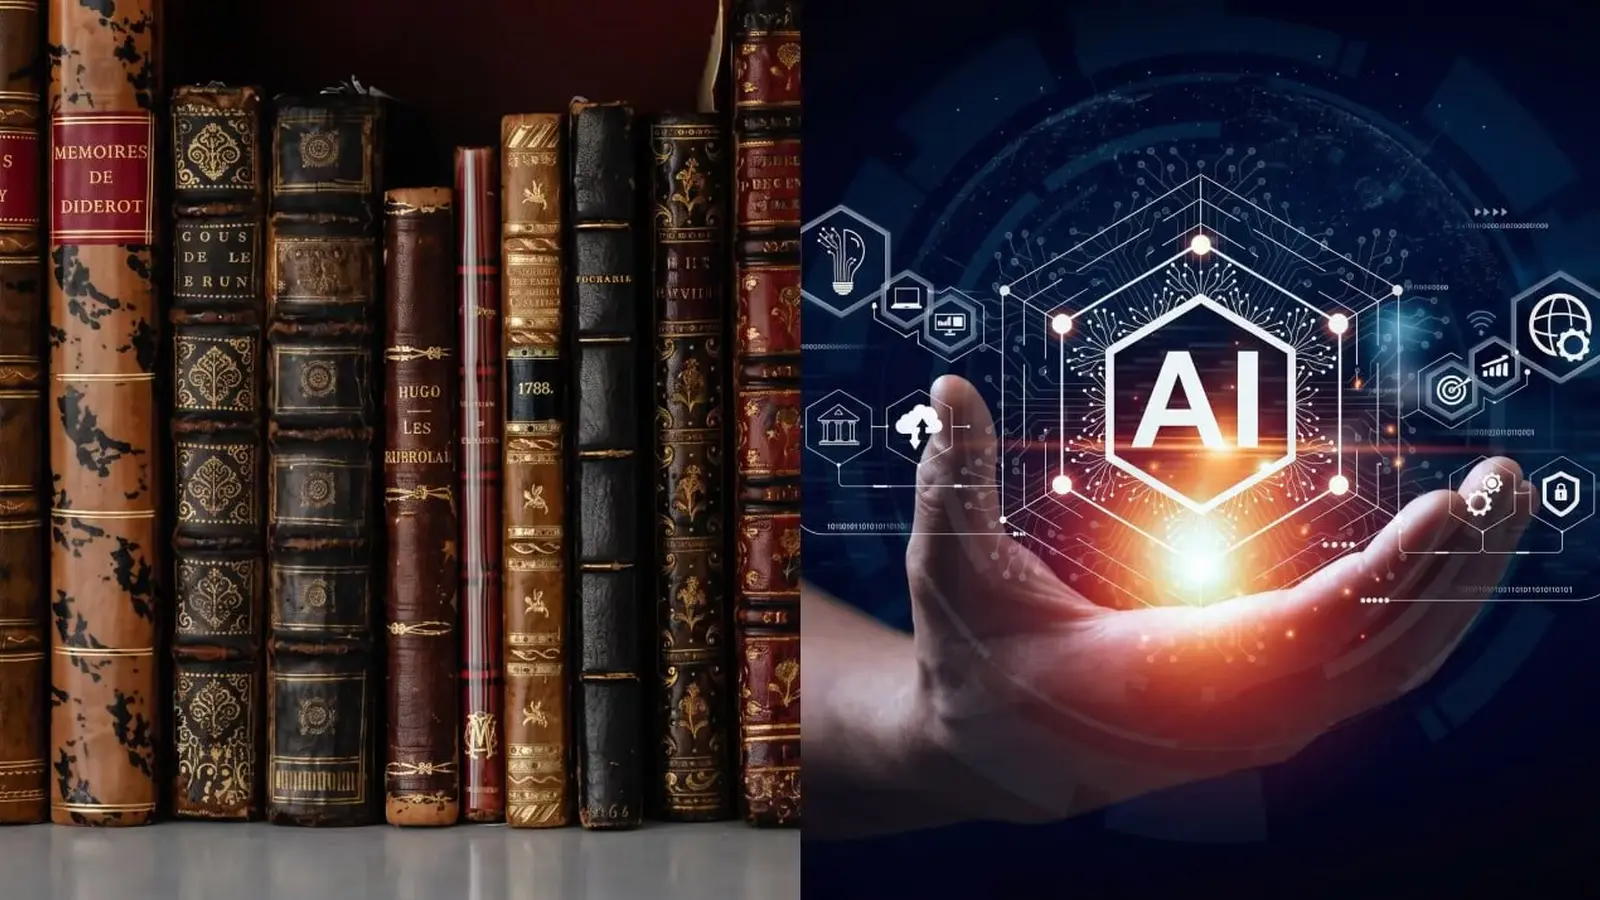
آنها با کامیونهای بینشان به انبارها میرسند. پالتهای بلند. جعبههای مقوایی با برچسبهای شابک. کاری آرام و بیسروصدا. سریعتر از حفاظت و نگهداری. این صحنه شبیه یک عملیات لجستیکی به نظر میرسد، اما محموله ادبیات است: میلیونها کتاب چاپی که راهی اسکنرهای صنعتی میشوند تا صفحهبهصفحه از هم جدا شوند.
آنچه دربارهاش میخوانید نظریه توطئه نیست. اسناد دادگاهی و گزارشهای افشاگران نشان میدهد چند شرکت هوش مصنوعی برای دیجیتالسازی انبوه متنهای چاپی، به روشهای اسکن مخرب روی آوردهاند. به جای تصویربرداری دقیق و محافظهکارانه که قفسه و عطف کتاب را حفظ کند، عطف کتابها بریده میشود و صفحات وارد اسکنرهای صنعتی پرسرعت میشوند. بدهبستان ماجرا بیرحمانه ساده است: سرعت و هزینه کمتر در برابر بقای فیزیکی نسخه چاپی.
در میان پروندهها، یک خط شواهد روشنگر دیده میشود. کارکنان سابقی که با گوگل بوکز و بعدها با پروژههایی مانند تلاشهای داخلی آنتروپیک، که در دعاوی حقوقی از آن با نام پروژه پاناما یاد شده است، همکاری داشتهاند شهادت دادهاند که از پیمانکارانی استفاده شده که هم اسکن ملایم از بالا و هم سرویس سریعتر و مخرب را ارائه میکردند. برای سازندگان هوش مصنوعی، این تصمیم کاملا عملگرایانه است. اسکن مخرب هزینه کمتری دارد و سرعت پردازش را چندین برابر افزایش میدهد.

برای نمونه، آنتروپیک متهم شده که میلیونها دلار برای استخراج داده آموزشی از کتابهای چاپی خریداریشده از فروشندگان واسطهای مانند بتر ورلد بوکز هزینه کرده و سپس همان نسخهها را پس از اسکن از بین برده است. هرچند یک قاضی اخیرا حکم داده که استفاده از آثار دارای حق نشر برای آموزش هوش مصنوعی در برخی زمینهها میتواند ذیل «استفاده منصفانه» قرار بگیرد، این حکم آنتروپیک را از اقدام تنبیهی مصون نکرد؛ زیرا در آرشیوهای خصوصی آن میلیونها نسخه دیجیتالشده بدون مجوز معتبر از نویسنده یا ناشر پیدا شد، اقدامی که بنا بر گزارشها جریمههایی تا حدود ۱.۵ میلیارد دلار به همراه داشته است.
ناشران هم دست روی دست نگذاشتهاند. ائتلافهایی از ناشران شکایتهایی مطرح کردهاند و مدعی شدهاند غولهای دیگر فناوری نیز برای آموزش مدلهای زبانی بزرگ از عناوین دارای حق نشر بدون اجازه استفاده کردهاند. نبرد حقوقی بر حقوق و جبران خسارت متمرکز است، اما پرسشی فرهنگی و بزرگتر بر فضای دادگاه سایه انداخته است: آیا شرکتهای خصوصی باید مجاز باشند موجودی کتابخانههای عمومی و خصوصی را به داده اختصاصی تبدیل کنند و سپس نسخههای اصلی را خرد و نابود کنند؟

پس چرا شرکتهای فناوری کتابهای دستدوم را پالتپالت میخرند؟ پاسخ صریح، داده آموزشی است. متنهای باکیفیت و نوشتهشده به دست انسان همچنان از ارزشمندترین ورودیها برای مدلهای زبانی پیشرفته به شمار میآیند. وب همین حالا از محتوای کمکیفیت تولیدشده با هوش مصنوعی لبریز است؛ محتوایی که با تحقیر «آشغال هوش مصنوعی» نامیده میشود و سیگنال اصلی را آلوده میکند. برای ساخت مدلهایی که نثر منسجم و دقیق تولید کنند، توسعهدهندگان به منابع اصیل نیاز دارند: داستانهای خوب ویراستهشده، آثار غیرداستانی دقیق و تکنگاریهای دانشگاهی کمیابی که در پیکرههای استخراجشده از وب پیدا نمیشوند.
اینجاست که بازارهایی مانند آیاسبیاندیبی وارد میدان میشوند؛ پایگاه دادهای آنلاین که بیش از ۱۱۱ میلیون عنوان را فهرست کرده است. سفارشهایی که از طریق چنین پلتفرمهایی ثبت میشوند دامنهای بسیار گسترده دارند؛ از هزار نسخه گرفته تا یک معامله واحد با یک میلیون کتاب. فروشندگانی که زمانی در هفته فقط چند ده کتاب ارسال میکردند، اکنون از افزایش پنجبرابری و گاهی حتی بیشتر خبر میدهند. خریداران اغلب مبالغ قابل توجهی میپردازند و علاقه چندانی به موضوع یا نویسنده نشان نمیدهند؛ اگر کتابی شابک داشته باشد، گزینهای بالقوه است.

این تغییر، هم ابعاد عملی دارد و هم ابعاد اخلاقی. از یک سو، دیجیتالسازی متنهای نادر میتواند کشف و دسترسی به آنها را بهبود دهد و اطمینان بدهد که محتوا در برابر فرسودگی فیزیکی دوام میآورد. از سوی دیگر، حذف گسترده آثار چاپی از چرخه دسترسی و سپس نابودی آنها، کتابخانهها، بازار کتاب دستدوم و پژوهشگران آینده را از دسترسی محروم میکند. آیا نسخههای نادر یا چاپهای دارای اهمیت تاریخی پیش از نابودی جدا میشوند؟ اسناد روشن نیستند. آنچه روشن است، این است که متنهای اسکنشده غالبا سر از پایگاههای داده خصوصی درمیآورند؛ پایگاههایی که فقط در اختیار شرکتهایی قرار دارند که هزینه آنها را پرداختهاند.
تصور کنید نسلی در آینده نیاز داشته باشد درستی یک نقلقول را بررسی کند یا یک حاشیهنویسی آرشیوی را مطالعه کند، اما جلدهای کلیدی دیگر در شکل فیزیکی وجود نداشته باشند و نسخههای دیجیتال هم پشت دیوارهای شرکتی نگهداری شوند. این بدهبستانها فراتر از قانون مالکیت فکری است. موضوع به پاسداری فرهنگی، دسترسی به دانش و این پرسش مربوط میشود که چه کسی مواد خامی را کنترل میکند که به هوش مصنوعی نوظهور نیرو میدهد.
نابود کردن کتابها برای آموزش هوش فردا پرسشی دشوار پیش میکشد: آیا پیشرفت فناوری ارزش از دست رفتن دائمی بخشهایی از میراث کاغذی ما را دارد؟

سیاستگذاران، کتابداران و فناوران باید تصمیم بگیرند که آیا احتکار خصوصی ادبیات دیجیتالشده را بپذیرند، دسترسی عمومی را الزامی کنند یا روشهای مورد استفاده برای ثبت و اسکن آثار چاپی را قانونمند سازند. این بحث تازه آغاز شده است، اما قفسهها همچنان جابهجا میشوند و ماشینها همچنان میچرخند. چه کسی از کتابها دفاع خواهد کرد؟
نظر بگذارید
نظرات
هنوز نظری ثبت نشده. اولین نفر باشید.