تصور کنید پخش زنده را شروع میکنید و بیسروصدا، صدا و تصویر شما به بخشی از مجموعه داده آموزشی موج بعدی هوش مصنوعی آمازون تبدیل میشود. این دقیقاً همان تغییری است که توئیچ اعلام کرده است، محتوای استریمها از این پس میتواند برای آموزش مدلهای آمازون استفاده شود، مگر اینکه سازندگان محتوا انصراف دهند.
بحثهای مربوط به حریم خصوصی درباره دادههای خام آموزشی دیگر صرفاً نظری نیست. توسعهدهندگان و تیمهای حقوقی سالهاست بر سر منابعی که مدلهای بزرگ از آنها یاد میگیرند درگیر بودهاند. برخی شرکتها با استفاده صرف از محتوای پلتفرمهای خودشان، از این جنجال فاصله میگیرند. برای نمونه، متا میتواند از صفحات عمومی فیسبوک و اینستاگرام استفاده کند. با این حال، پروفایلهای خصوصی دستکم در اصل همچنان خارج از دسترس باقی میمانند.
آنچه توئیچ را متفاوت میکند، مقیاس و ماهیت صمیمی محتوای آن است. استریمها طولانی، چندرسانهای و بینظماند: ساعتها صدا، تصویر دوربین چهره، چت زنده، گیمپلی و لحظههای ناگهانی که در آرشیوهای گزینششده پیدا نمیشوند. برای پژوهشگران هوش مصنوعی، همین بینظمی یک معدن طلاست تا به مدلها بیاموزند طبیعیتر حرف بزنند، واکنش نشان دهند و شبیه انسانهای واقعی رفتار کنند. اما برای سازندگان محتوا، این وضعیت شبیه آن است که کسی در انباری دیجیتال شخصیشان جستوجو کند.
پخشهای قبلی شما میتوانند به نسل بعدی هوش مصنوعی یاد بدهند چگونه حرف بزند، چگونه دیده شود و چگونه واکنش نشان دهد.
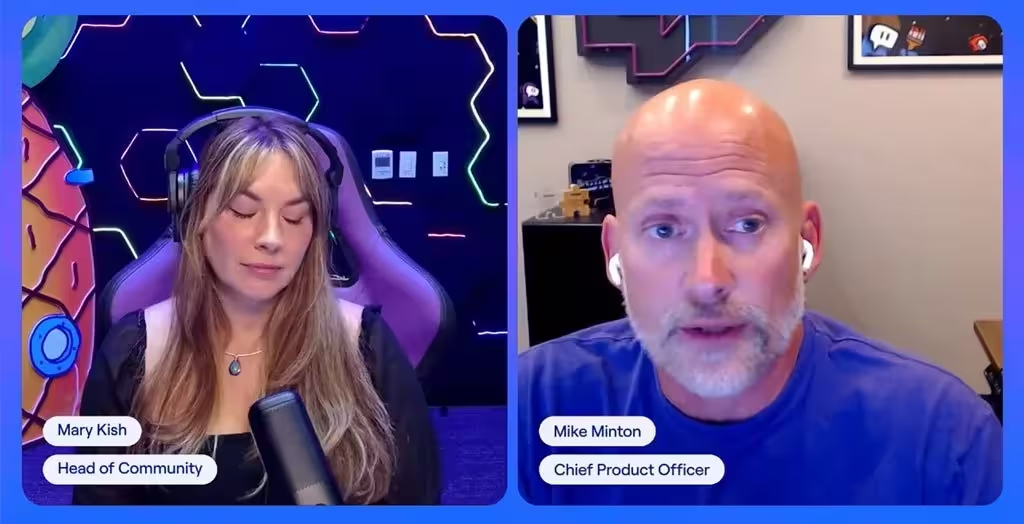
آمازون میگوید سازندگان محتوا میتوانند انصراف دهند. اما انتخاب پیشفرض، مشارکت در این روند است. بسیاری از استریمرها فقط زمانی از این تغییر باخبر میشوند که بهروزرسانی سیاستها از مقابل چشمشان عبور میکند یا هنگام یک استریم شرکتی، چت پر از اعتراض و بحث میشود. این انفجار واکنشها همین حالا هم رخ داده است: در یکی از پخشهای اخیر توئیچ با حضور مدیران پلتفرم، هزاران پاسخ خشمگین در چت ثبت شد؛ نشانهای روشن از اینکه این موضوع برای جامعه کاربران تا چه اندازه حساس و ناپایدار است.
نگرانی گستردهتر این است که این ماجرا فقط یک اتفاق مقطعی نباشد. استریمرها میپرسند آیا آرشیوهای قدیمی آنها مدتها پیش و پیش از هرگونه اطلاعرسانی جمعآوری شدهاند یا نه. غولهای فناوری معمولاً جمعآوری بیرویه دادهها را انکار میکنند، اما مدلهای زبانی و چندرسانهای آشکارا بر بخشهای عظیمی از وب آموزش دیدهاند: تصویرها، کتابها، ویدئوها و اکنون ظاهراً استریمهای زنده هم در همین محدوده قرار گرفتهاند.
پس سازندگان محتوا چه باید بکنند؟ تنظیمات حساب خود را بررسی کنید. متنهای ریز و جزئیات سیاستها را بخوانید. تصمیم بگیرید آیا میخواهید محتوایتان خوراک سیستمهای هوش مصنوعی مولد باشد یا نه. همچنین از پلتفرمها بخواهید بهجای گزینههای پنهان در تنظیمات، مسیرهای رضایتگیری شفافتر و فعالانهتری ارائه کنند. بحث بر سر اینکه مالک توجه آنلاین چه کسی است هنوز به پایان نرسیده، اما برای هر کسی که پخش زنده انجام میدهد، این پرسش ناگهان کاملاً شخصی شده است.


نظر بگذارید
نظرات (2)
وحشتناک! انگار دارن یه مدل از خودمون میسازن بدون اجازه، استریمرها باید فریاد بزنن، ولی همزمان میدونم بعضیا از این تکنولوژی سود میبرن… گیج شدم
واقعاً؟ یعنی آرشیوهای قدیمی بدون اطلاع جمع شدن؟ اینجوری انگار دارن تو انباری شخصی خُرد میکنن، شفافیت نمیخوان بذارن، یا حداقل یه پنجره واضح برای انصراف؟